ss-data-skills
Health Warn
- License — License: MIT
- Description — Repository has a description
- Active repo — Last push 0 days ago
- Low visibility — Only 8 GitHub stars
Code Pass
- Code scan — Scanned 1 files during light audit, no dangerous patterns found
Permissions Pass
- Permissions — No dangerous permissions requested
No AI report is available for this listing yet.
Open source AI Agent skills for practical data development workflows
拾穗数据技能库
一套面向数据从业者的工作技能库。
我们把数据分析、数据开发、数据治理、BI、数据产品和日常汇报中高频、可复用的工作动作,整理成清晰的技能说明、上下文模板和示例。
这个项目由 拾穗数据工作室 发起,优先服务拾穗数据会员的学习、工作和项目实践;同时免费开源,供更多数据从业者使用、修改和共建。
- 拾穗数据主站:ss-data.cc
- 数据从业者全栈知识库:pro.ss-data.cc
为什么需要它
数据工作里有很多动作,看起来不起眼,却决定了结果是否可靠:
- 接到一句模糊需求,怎么澄清成可执行任务
- 定义一个指标,怎么避免口径打架
- 设计一张表,怎么守住粒度、分区和更新策略
- 审查一段 SQL,怎么发现漏算、重复计算和性能风险
- 一个经营看板,怎么判断它能不能支持业务决策
- 一个业务指标异常,怎么拆成可验证的归因路径
- 一张表或一个任务,怎么写成别人能接手的数据文档
- 一次数据事故,怎么复盘到机制改进,而不是停在“这次修了”
这些不是“提示词技巧”,而是数据从业者每天都要面对的基本功。
技能库希望做的事情很简单:把这些高频动作沉淀成清晰、可复制、可落地的工作方法。
快速开始
第一次使用建议从 快速开始 进入。
如果你还不了解 Skill 是什么、为什么不是普通提示词,可以先看 Skill 入门教程。
如果你已经知道自己要做什么,可以直接看 技能索引。
如果你要把技能用到真实工作里,建议同时使用 上下文使用指南 和 上下文模板。
想看具体输入输出,可以从 示例索引 开始。
技能目录
数据开发与治理
| 技能 | 适用场景 |
|---|---|
| 数据需求澄清 | 把模糊的数据需求整理成可开发、可分析、可验收的任务 |
| 指标口径审查 | 审查指标定义、分子分母、时间窗口、边界条件和业务风险 |
| 数仓表设计建议 | 设计或审查数仓表结构、分层、粒度、分区和更新策略 |
| SQL 审查 | 审查 SQL 的逻辑正确性、性能风险和口径一致性 |
| 数据质量规则生成 | 为表、任务或指标生成数据质量规则和告警建议 |
| 血缘影响分析 | 评估表、字段、指标或任务变更对下游的影响 |
| 数据工具集成规划 | 规划数据库、API、BI、调度、消息等工具接入方案 |
数据分析与业务判断
| 技能 | 适用场景 |
|---|---|
| 探索性数据分析 | 对新数据集做结构、质量、分布、异常和关系探索 |
| 业务归因分析 | 对 GMV、激活、留存、收入等业务指标异常做归因分析 |
| 漏斗分析 | 分析注册、激活、下单、支付等有序转化路径 |
| 留存 Cohort 分析 | 分析留存、复购、活跃回访和 Cohort 差异 |
| A/B 实验分析 | 设计、审查或解读 A/B 实验,判断实验是否可信 |
| 看板审查 | 审查看板是否能支持业务决策、定位问题和推动行动 |
| 行业市场调研 | 为行业、竞品、产品机会和用户需求建立调研框架 |
表达、协作与复盘
| 技能 | 适用场景 |
|---|---|
| 日报写作 | 把当天零散工作整理成清楚、可同步的日报 |
| 周报月报写作 | 写周报、月报、项目进展和向上同步材料 |
| 数据分析报告写作 | 把分析结果整理成可决策的数据分析报告 |
| 数据汇报 PPT 架构 | 把报告、项目进展或技术内容整理成 PPT 叙事大纲 |
| 数据文档写作 | 为表、指标、SQL 任务、看板或数据产品生成可交接的数据文档 |
| 数据事故复盘 | 写数据事故复盘,沉淀影响、时间线、根因和预防措施 |
常见工作流
需求澄清 -> 指标口径 -> 表设计 -> SQL 审查 -> 质量规则 -> 数据文档
数据探索 -> 漏斗 / 留存 / 实验分析 -> 分析报告 -> PPT 汇报
业务异常 -> 归因分析 -> 看板审查 -> 日报 / 周报 / 管理层汇报
字段或口径变更 -> 血缘影响分析 -> 通知协作 -> 上线验证 -> 事故复盘
如何使用
每个技能都包含:
- 适用场景
- 不适用场景
- 输入信息
- 上下文建议
- 工作流程
- 输出格式
- 质量标准
- 示例 Prompt
最简单的方式:
- 打开你需要的技能文档。
- 复制其中的说明和示例。
- 填入你的业务背景、数据材料和输出要求。
- 交给你正在使用的工具执行。
推荐同时准备上下文。上下文模板见 context/README.md。
如果你是第一次接触 Skill,建议先读 Skill 入门教程,再回到这里选择具体技能。
质量说明
这个项目不是提示词合集。每个正式收录的技能都要回答三个问题:
- 什么时候使用
- 需要提供什么材料
- 应该产出什么结果
我们会持续补充示例、上下文模板和真实场景说明,让这些技能尽量贴近日常工作,而不是停留在泛泛建议。
拾穗数据在做什么
拾穗数据是面向 AI 时代数据从业者的学习与实践社区。
我们关心的问题很简单:
当 SQL、报表和部分开发动作被 AI 快速压缩,数据人还应该靠什么继续变值钱?
我们的答案不是追热点,而是回到三个问题:
- 数据基本功是否扎实
- 是否能把技术动作和业务问题连起来
- 是否能在 AI 时代重构自己的工作流
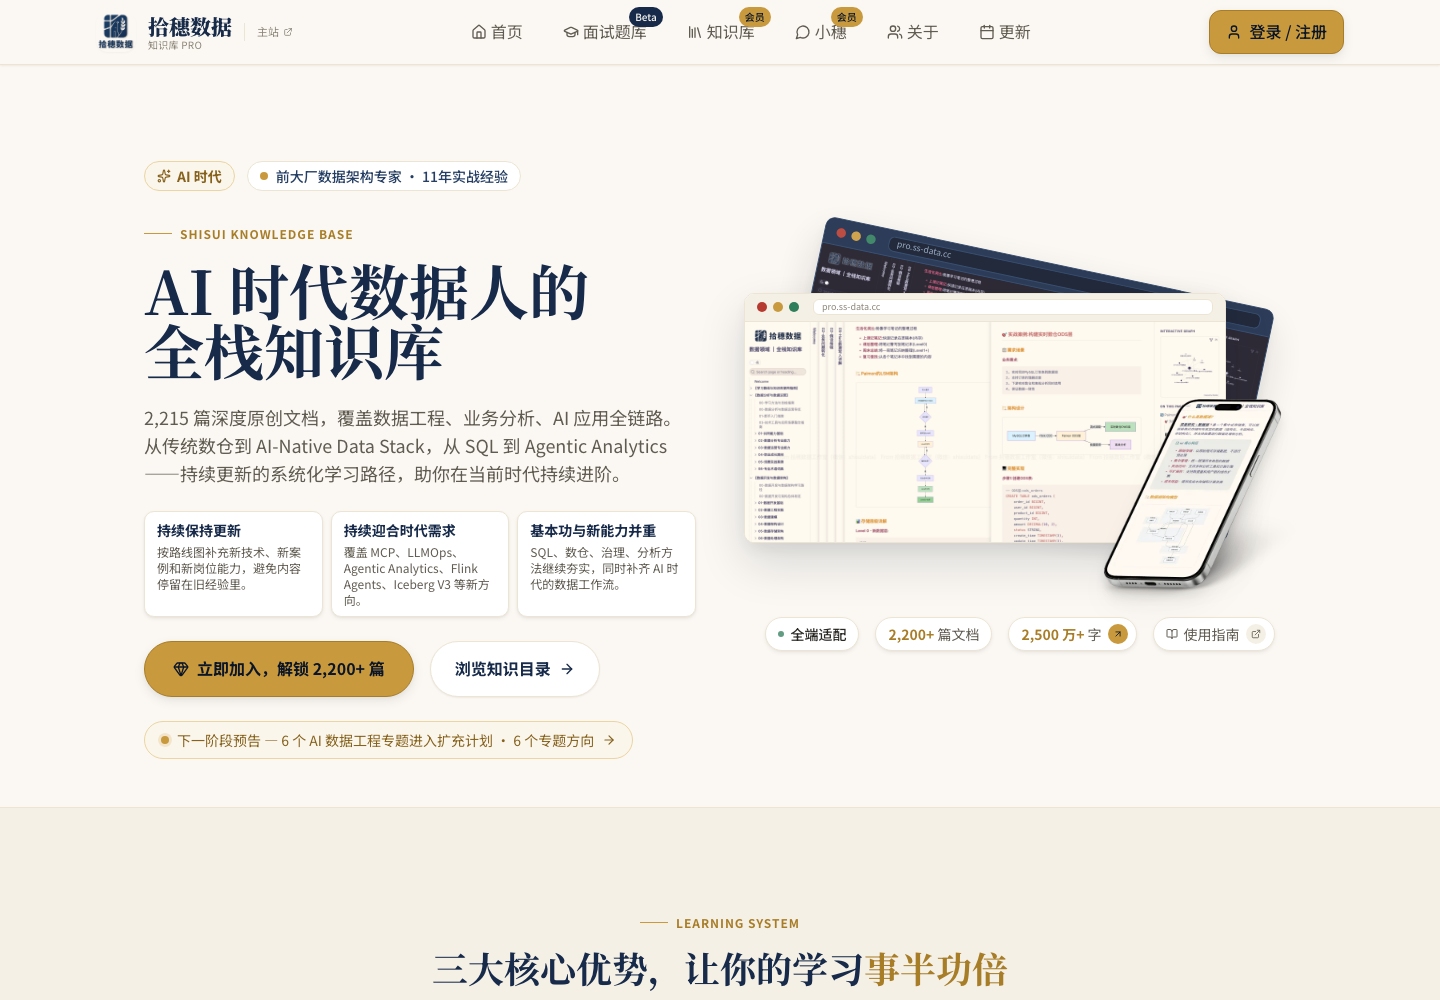
数据从业者全栈知识库 是拾穗数据的核心会员产品,覆盖数据工程、数据开发与架构、数据分析与运营、数据治理、技术工具、行业业务、求职就业以及 AI 与大数据等方向。
如果你希望系统学习数据领域,或者想跟着拾穗数据一起升级自己的数据工作流,可以从这里开始:
共建方式
欢迎提交 Issue 或 Pull Request。
适合提交的内容包括:
- 新的技能场景
- 现有技能的输出改进
- 脱敏后的真实工作案例
- 更好的示例输入和示例输出
- 针对某个工具、行业或平台的补充说明
提交前请阅读 贡献指南。
维护者
本仓库归属 shisuidata 组织,由 rockythink 负责主要维护和 GitHub 日常操作。
License
本仓库采用 MIT License 开源。你可以免费使用、复制、修改和分发这些技能。
Reviews (0)
Sign in to leave a review.
Leave a reviewNo results found